Domain 62000.de kaufen?
Wir ziehen mit dem Projekt
62000.de um.
Sind Sie am Kauf der Domain
62000.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain 62000.de kaufen?
Was sind die gängigen Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigen Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Klassen oder Kategorien zu unterteilen und Muster zu erkennen. Sie werden häufig in der Informatik und Statistik eingesetzt, um Vorhersagen zu treffen oder Muster in den Daten zu identifizieren. **
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigsten Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Kategorien oder Klassen zu unterteilen und Muster oder Trends zu identifizieren. Sie werden häufig in der Informatik und Statistik eingesetzt, um Prognosen zu treffen oder Erkenntnisse aus den Daten zu gewinnen. **
Ähnliche Suchbegriffe für Logistik-Klassifikation
Top-Angebote
Produkte zum Begriff Logistik-Klassifikation:
-
SIKU 6324 UPS Logistik SetDie braunen Transporter von UPS gehören seit Jahrzehnten zum Straßenbild. Die flinken Paketzusteller springen aus ihren Fahrzeugen und eilen mit der Lieferung zum Kunden. Aber wie kommt das Paket zum Zusteller? Mit dem UPS Logistik Set wird die komplexe Logistik bei der Paketzustellung leicht verständlich und zu einem spannenden Spielthema. Das Set besteht aus einem Gabelstapler, einer 3-Achs-Zugmaschine und einem Transporter in der typischen Farbgebung von UPS. Das Hubgerüst des Linde Gabelstaplers ist beweglich und damit lassen sich die Kofferaufbauten beladen. Dazu können die Heckklappen geöffnet werden. Das Fahrerhaus und die Fahrgestelle der 3-Achs-Zugmaschine und des Zentralachsanhängers sind aus Metall gefertigt. Auch der Paketwagen ist komplett aus Metall gefertigt.19,99 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter


-
Was sind die verschiedenen Methoden zur Klassifikation von Daten?
Die verschiedenen Methoden zur Klassifikation von Daten sind: Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Entscheidungsbäume teilen die Daten anhand von Merkmalen auf, künstliche neuronale Netze ahmen das menschliche Gehirn nach und Support Vector Machines finden die optimale Trennlinie zwischen den Datenpunkten. **
-
Was ist AO Klassifikation?
Die AO-Klassifikation ist ein System zur Klassifizierung von Frakturen, das von der Arbeitsgemeinschaft für Osteosynthesefragen (AO) entwickelt wurde. Sie dient dazu, Frakturen nach ihrem Schweregrad, ihrer Lokalisation und anderen relevanten Faktoren zu klassifizieren. Die AO-Klassifikation hilft Ärzten bei der Entscheidung über die geeignete Behandlung für eine bestimmte Fraktur und ermöglicht eine einheitliche Kommunikation über Frakturen in der medizinischen Fachwelt. Sie ist international anerkannt und wird häufig in der Orthopädie und Unfallchirurgie angewendet. Die AO-Klassifikation besteht aus verschiedenen Kategorien, die jeweils spezifische Informationen über die Fraktur liefern, um eine präzise Diagnose und Behandlung zu ermöglichen. **
-
Was ist die TNM Klassifikation?
Die TNM-Klassifikation ist ein System, das verwendet wird, um den Ausdehnungsgrad von Tumoren zu beschreiben. Dabei werden drei Hauptkriterien berücksichtigt: Tumorgröße (T), Lymphknotenbefall (N) und Metastasen (M). Anhand dieser Kriterien wird der Tumor in verschiedene Stadien eingeteilt, um eine Prognose abzugeben und die geeignete Behandlung zu bestimmen. Die TNM-Klassifikation wird vor allem in der Onkologie verwendet, um die Schwere und das Fortschreiten von Krebserkrankungen zu bestimmen. Sie dient auch dazu, den Verlauf der Erkrankung zu überwachen und die Wirksamkeit der Behandlung zu beurteilen. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik?
Die gängigsten Methoden zur Klassifikation von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu erkennen. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungelabelte Daten nutzt. **

Was sind die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft?
Die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning unlabeled Daten verwendet, um Muster und Strukturen zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungabelte Daten nutzt, um Modelle zu verbessern. **
"Was sind die grundlegenden Prinzipien der Klassifikation von Objekten oder Informationen?" "Warum ist die Klassifikation von Daten und Informationen in verschiedenen Bereichen und Disziplinen wichtig?"
Die grundlegenden Prinzipien der Klassifikation sind die Identifikation von Gemeinsamkeiten, die Gruppierung von ähnlichen Objekten und die Zuordnung zu Kategorien. Die Klassifikation von Daten und Informationen ist wichtig, um Ordnung zu schaffen, den Zugriff zu erleichtern und die Effizienz bei der Verwaltung zu erhöhen. In verschiedenen Bereichen und Disziplinen ermöglicht die Klassifikation eine bessere Organisation, Analyse und Nutzung von Informationen für spezifische Zwecke. **
Top-Angebote
Produkte zum Begriff Logistik-Klassifikation:
-
SIKU 6324 UPS Logistik SetDie braunen Transporter von UPS gehören seit Jahrzehnten zum Straßenbild. Die flinken Paketzusteller springen aus ihren Fahrzeugen und eilen mit der Lieferung zum Kunden. Aber wie kommt das Paket zum Zusteller? Mit dem UPS Logistik Set wird die komplexe Logistik bei der Paketzustellung leicht verständlich und zu einem spannenden Spielthema. Das Set besteht aus einem Gabelstapler, einer 3-Achs-Zugmaschine und einem Transporter in der typischen Farbgebung von UPS. Das Hubgerüst des Linde Gabelstaplers ist beweglich und damit lassen sich die Kofferaufbauten beladen. Dazu können die Heckklappen geöffnet werden. Das Fahrerhaus und die Fahrgestelle der 3-Achs-Zugmaschine und des Zentralachsanhängers sind aus Metall gefertigt. Auch der Paketwagen ist komplett aus Metall gefertigt.19,99 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigen Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigen Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Klassen oder Kategorien zu unterteilen und Muster zu erkennen. Sie werden häufig in der Informatik und Statistik eingesetzt, um Vorhersagen zu treffen oder Muster in den Daten zu identifizieren. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik und Statistik?
Die gängigsten Methoden zur Klassifikation von Daten sind Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Diese Methoden werden verwendet, um Daten in verschiedene Kategorien oder Klassen zu unterteilen und Muster oder Trends zu identifizieren. Sie werden häufig in der Informatik und Statistik eingesetzt, um Prognosen zu treffen oder Erkenntnisse aus den Daten zu gewinnen. **
-
Was sind die verschiedenen Methoden zur Klassifikation von Daten?
Die verschiedenen Methoden zur Klassifikation von Daten sind: Entscheidungsbäume, künstliche neuronale Netze und Support Vector Machines. Entscheidungsbäume teilen die Daten anhand von Merkmalen auf, künstliche neuronale Netze ahmen das menschliche Gehirn nach und Support Vector Machines finden die optimale Trennlinie zwischen den Datenpunkten. **
-
Was ist AO Klassifikation?
Die AO-Klassifikation ist ein System zur Klassifizierung von Frakturen, das von der Arbeitsgemeinschaft für Osteosynthesefragen (AO) entwickelt wurde. Sie dient dazu, Frakturen nach ihrem Schweregrad, ihrer Lokalisation und anderen relevanten Faktoren zu klassifizieren. Die AO-Klassifikation hilft Ärzten bei der Entscheidung über die geeignete Behandlung für eine bestimmte Fraktur und ermöglicht eine einheitliche Kommunikation über Frakturen in der medizinischen Fachwelt. Sie ist international anerkannt und wird häufig in der Orthopädie und Unfallchirurgie angewendet. Die AO-Klassifikation besteht aus verschiedenen Kategorien, die jeweils spezifische Informationen über die Fraktur liefern, um eine präzise Diagnose und Behandlung zu ermöglichen. **
Ähnliche Suchbegriffe für Logistik-Klassifikation
-
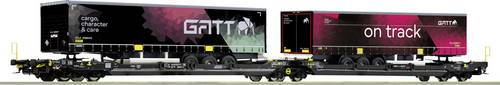
Roco 6600170 Tragwagen DC TX LogistikDoppeltaschen-Gelenkwagen, Gattung Sdggmrs 738/T3000e, der TX Logistik. Der Megatrailer-Taschenwagen "T3000" ist die Weiterentwicklung des Typs T2000. Der Laderaum ist auf die tiefliegenden Fahrzeugteile der Megatrailer abgestimmt. Es können aber auch Trailer der älteren Bauarten sowie bis zu 7,82 m lange Wechselbehälter und Container verladen werden.94,03 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Internationale Klassifikation psychischer StörungenInternationale Klassifikation psychischer Störungen , ICD-10 Kapitel V (F). Klinisch-diagnostische Leitlinien , Polituren & Wachse > Autopflege & Aufbereitung , Auflage: 10. Auflage, Erscheinungsjahr: 20150921, Produktform: Kartoniert, Redaktion: Dilling, Horst~Mombour, Werner~Schmidt, Martin H., Edition: REV, Auflage: 15010, Auflage/Ausgabe: 10. Auflage, Seitenzahl/Blattzahl: 449, Themenüberschrift: MEDICAL / Reference, Keyword: Diagnostik; Verhaltensstörungen; diagnostische Leitlinien; psychische Störungen; Psychosomatik; international, Fachschema: Psychische Erkrankung / Störung~Störung (psychologisch)~Psychiatrie - Psychiater, Fachkategorie: Psychische Störungen, Warengruppe: HC/Medizin/Andere Fachgebiete, Fachkategorie: Psychiatric and mental disorders, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Hogrefe AG, Verlag: Hogrefe AG, Verlag: Hogrefe AG, Länge: 193, Breite: 116, Höhe: 19, Gewicht: 350, Produktform: Kartoniert, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Vorgänger EAN: 9783456853864 9783456850184 9783456848471 9783456845586 9783456841243, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0160, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,38,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist die TNM Klassifikation?
Die TNM-Klassifikation ist ein System, das verwendet wird, um den Ausdehnungsgrad von Tumoren zu beschreiben. Dabei werden drei Hauptkriterien berücksichtigt: Tumorgröße (T), Lymphknotenbefall (N) und Metastasen (M). Anhand dieser Kriterien wird der Tumor in verschiedene Stadien eingeteilt, um eine Prognose abzugeben und die geeignete Behandlung zu bestimmen. Die TNM-Klassifikation wird vor allem in der Onkologie verwendet, um die Schwere und das Fortschreiten von Krebserkrankungen zu bestimmen. Sie dient auch dazu, den Verlauf der Erkrankung zu überwachen und die Wirksamkeit der Behandlung zu beurteilen. **
-
Was sind die gängigsten Methoden zur Klassifikation von Daten in der Informatik?
Die gängigsten Methoden zur Klassifikation von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu erkennen. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungelabelte Daten nutzt. **
-
Was sind die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft?
Die wichtigsten Methoden zur Klassifikation von Daten in der Wissenschaft sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning unlabeled Daten verwendet, um Muster und Strukturen zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze, indem es sowohl gelabelte als auch ungabelte Daten nutzt, um Modelle zu verbessern. **
-
"Was sind die grundlegenden Prinzipien der Klassifikation von Objekten oder Informationen?" "Warum ist die Klassifikation von Daten und Informationen in verschiedenen Bereichen und Disziplinen wichtig?"
Die grundlegenden Prinzipien der Klassifikation sind die Identifikation von Gemeinsamkeiten, die Gruppierung von ähnlichen Objekten und die Zuordnung zu Kategorien. Die Klassifikation von Daten und Informationen ist wichtig, um Ordnung zu schaffen, den Zugriff zu erleichtern und die Effizienz bei der Verwaltung zu erhöhen. In verschiedenen Bereichen und Disziplinen ermöglicht die Klassifikation eine bessere Organisation, Analyse und Nutzung von Informationen für spezifische Zwecke. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.